Laboratori e infrastrutture per l'Open Science
Attraverso i propri laboratori e le infrastrutture di ricerca, l'Università degli Studi del Sannio mette a disposizione competenze, tecnologie e risorse avanzate a supporto della comunità scientifica, promuovendo la collaborazione interdisciplinare e la valorizzazione dei risultati della ricerca.
Particolare rilevanza assume lo sviluppo di infrastrutture digitali aperte per l’elaborazione di dati massivi ad alte prestazioni e l'Intelligenza Artificiale, che ampliano le opportunità di ricerca e sperimentazione, favorendo l'accesso a capacità computazionali avanzate e lo sviluppo di nuove metodologie scientifiche.
L'Ateneo sostiene pertanto un ecosistema della ricerca aperto e interconnesso con altri centri e laboratori distribuiti, capace di favorire la cooperazione interna all’Università, ma anche con altre università, enti di ricerca, imprese e territorio, contribuendo al progresso scientifico, all'innovazione e alla diffusione della conoscenza.
Infrastruttura HPC e Intelligenza Artificiale
Azione strategica: miglioramento delle condizioni operative di svolgimento delle attività di ricerca, anche attraverso il potenziamento delle infrastrutture a supporto della ricerca.
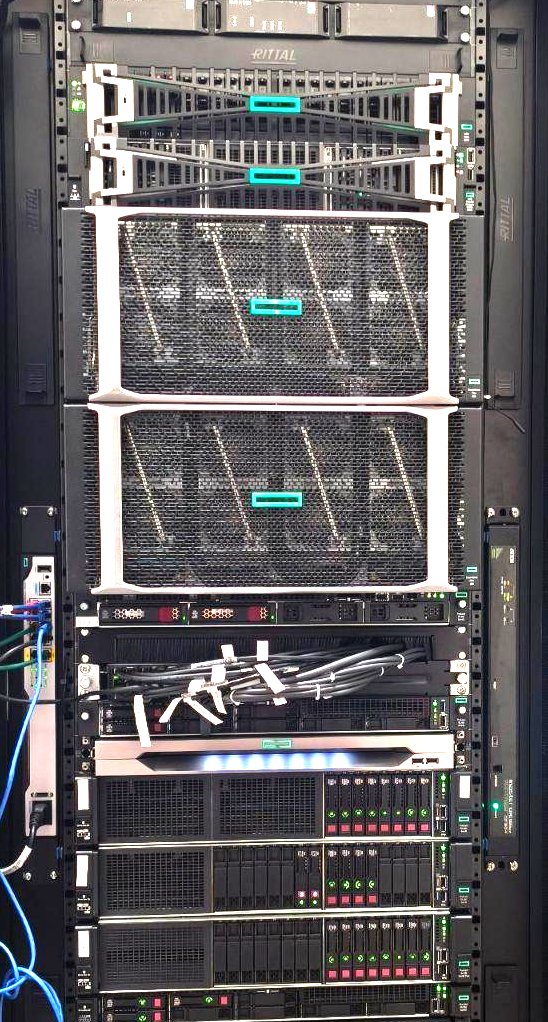
L'infrastruttura di calcolo ad alte prestazioni (HPC) e intelligenza artificiale dell'Ateneo è un polo tecnologico progettato per gestire carichi di lavoro intensivi e prolungati. È accessibile da remoto e utilizzabile on demand da gruppi di ricerca accademici, laboratori di AI e Deep Learning, imprese ed enti del territorio e per attività di formazione avanzata.
Infrastruttura realizzata con il contributo finanziario del Ministero dell'Università e della Ricerca (MUR), a valere sul Fondo per la promozione e lo sviluppo delle politiche del Programma Nazionale per la Ricerca (PNR), di cui al D.M. n. 737 del 25 giugno 2021.
 1 2 3 4
Componenti dell'infrastruttura
- 1HPE MSA 2070 – storage centralizzato SAN/NAS
6 × 3,84 TB SAS in RAID 5 · 19,2 TB utilizzabili · 200 Gbps di banda aggregata - 2HPE ProLiant DL384 Gen12 – nodo GPU, 2 × NVIDIA GH200 NVL2 Grace Hopper
2 × NVIDIA Grace ARM Neoverse V2, 144 core ARM · 2 × GPU GH200, 288 GB VRAM · 1,2 TB RAM condivisa CPU-GPU · 6 × 3,2 TB NVMe Gen5 + 2 × 1,92 TB NVMe Gen4 · rete Mellanox 100/200 Gbps - 3HPE Superdome Flex 280 – nodo a memoria condivisa (NUMA unificata, 2 chassis)
8 × Intel Xeon Platinum 8360H, 192 core fisici / 384 virtuali · 2 TB RAM DDR4-3200 (espandibile a 24 TB) · oltre 12 TB SSD SAS 24G · rete 1/10/25 Gbps - 4Nodo di gestione – gestione virtualizzata del cluster
Intel Xeon Silver 4208 · 64 GB RAM · 2 × SSD 1 TB in RAID 1
La rete è gestita da uno switch Mellanox ad alte prestazioni (16 porte 10/25 Gbps e 4 porte 40/100 Gbps) che si appoggia al data center ospitante; il sistema è alloggiato in un rack climatizzato e protetto da UPS. L'intero ecosistema è gestito tramite la piattaforma open source OpenStack, che fornisce risorse di calcolo, memoria e storage in modo flessibile.
Principali ambiti applicativi
HPC
Simulazioni complesse, modellazione matematica e analisi di Big Data, sfruttando l'elevata densità di core e la RAM condivisa.
Addestramento e test di modelli AI
Training da zero, fine-tuning e validazione di modelli di Deep Learning grazie alla memoria unificata del sistema Grace Hopper.
Architetture LLM e Agentic AI
Elaborazione in locale di Large Language Model con elevato consumo di VRAM e sviluppo di sistemi multi-agente autonomi con capacità di ragionamento e pianificazione.
Attività di ricerca sull'infrastruttura
Laboratori dei Dipartimenti
Connessioni con altri Centri di Ricerca e Laboratori Distribuiti

